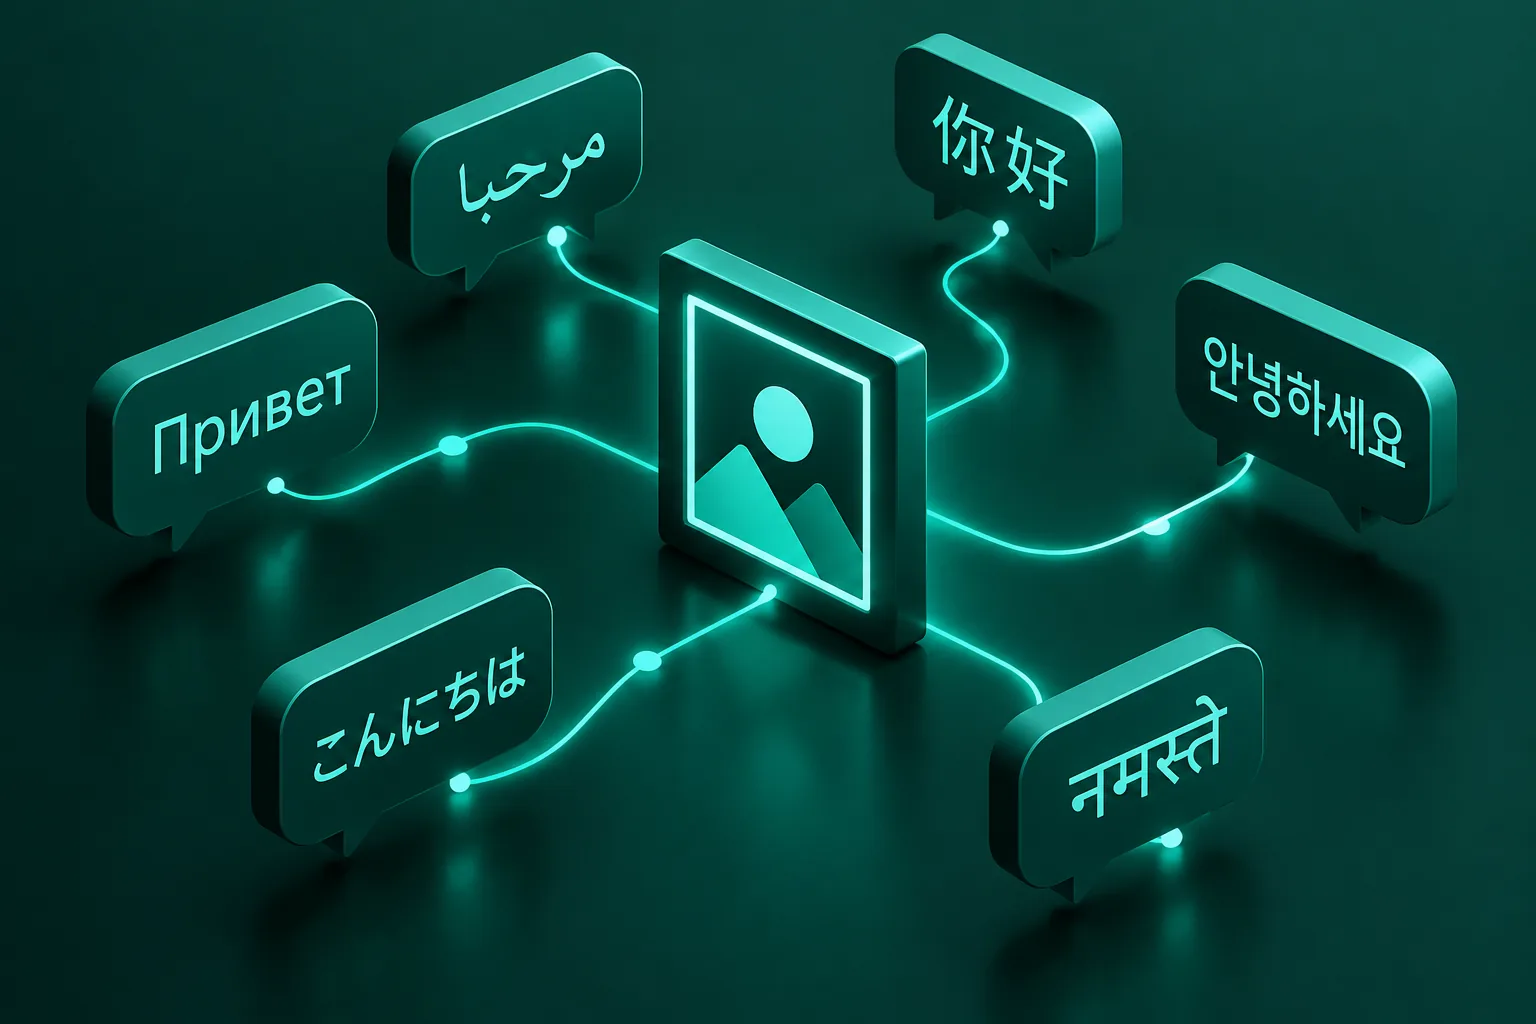
多言語AIソーシャルリスニングは、まず投稿ごとの言語を判定し、その言語で分析します。そのため、アラビア語、日本語、スペイン語、フランス語の投稿を無理に英語経由で処理することはありません。ビジュアルソーシャルリスニングは、ロゴ検出などの画像分析を加え、テキストのないブランドの言及を見つけます。購入前に、自社の投稿で両方をテストしてください。
主なポイント
- 多言語リスニングは一連の流れです。言語判定、言語別の分析、そして読める1つの言語でのレポートという順です。
- ビジュアルリスニングは、キーワード検索では見えない、画像や動画フレーム内のブランドを見つけます。
- ベンダーは「100言語に対応」と言うことが多いものの、各言語がどれだけうまく機能するかは明かしません。自社が販売している言語をテストしましょう。
- 言語ごとに、ラベル付きの小さなテストセットを作り、判定、感情、トピック、ロゴを別々に採点します。
- 自社のデータで再現できない精度の数字は、ひとつも信用しないでください。
多言語ソーシャルリスニングはどのように機能しますか?
4つのステップで動作します。投稿を収集し、投稿ごとの言語を判定し、その言語で投稿を分析し、結果をレポート用にまとめる流れです。弱点になりやすいのは、真ん中の2つのステップです。
- 収集:英語のリストを翻訳したものではなく、各言語で書いたキーワードを使って投稿を集めます。
- 判定:すべての投稿の言語を判定します。GoogleのCloud Translationのドキュメントには、典型的な出力が示されています。言語コードの順位付きリストで、それぞれに0〜1の信頼度が付きます。
- 分析:その言語に対応したモデルで、感情、トピック、エンティティを分析します。
- レポート:1つの作業言語でまとめ、元のテキストもワンクリックで見られるようにしておくのが理想です。
同じ資料には、短い文章や複数言語が混在したテキストを判定がどう扱うかは書かれていません。想定するのではなく、テストで確かめる項目として扱ってください。
言語判定は、なぜ見た目より難しいのですか?
SNSの投稿は短く、くだけていて、複数の言語が混ざることも多くあります。3語のコメント、ハッシュタグ、絵文字の羅列では、判定の手がかりがほとんどありません。
つまずきやすいポイントは次のとおりです。
- 方言。アラビア語の投稿は、現代標準アラビア語でも地域の方言でも書かれます。フォーマルな文章で調整されたツールは、スラングを読み違えることがあります。
- 音写表記。アラビア語や日本語をラテン文字で入力する人もいます。判定ツールがそうした投稿を英語と判定することがあります。
- コードスイッチング。1つの文に2つの言語が含まれることがあります。
- 文字体系。日本語は1つの文に複数の文字体系が混在するため、単語の区切りがはっきりしません。
- ブランド名。日本語やアラビア語の文中にラテン文字で書かれたブランド名も、きちんと一致させる必要があります。
ビジュアルAIソーシャルリスニングとは?
ビジュアルAIソーシャルリスニングは、投稿内の言葉だけでなく、画像や動画も分析します。最もよくある使い方は、誰もブランド名を書いていない画像の中から、自社や競合のロゴを見つけることです。
GoogleのCloud Visionのドキュメントは、ロゴ検出を、画像内の有名な製品ロゴを見つける機能と説明しています。各結果には、ロゴの説明、信頼度スコア、表示位置を示すバウンディングボックスが付きます。どのベンダーを見るときも、何が見つかったか、モデルがどれくらい確信しているか、どこにあるかという形を確認しましょう。
ビジュアルリスニングは、シーン、オブジェクト、画像内のテキストも対象にします。ベンダーが実際にどれに対応しているのか、そして動画フレームでも動作するのか、静止画だけなのかを確認してください。
どの言語を、どうテストすべき?
売上に関わる言語をテストし、言語ごとに専用のラベル付きサンプルを用意します。下の表は4言語の出発点となる計画で、それぞれ「ソーシャルリスニングツール」を表す現地の検索語を載せています。
| 言語 | 現地の用語 | ストレステストする内容 |
|---|---|---|
| アラビア語 | أدوات الاستماع الاجتماعي | 方言の投稿、右から左へ書くテキスト、ラテン文字のアラビア語、アラビア語の文中のブランド名 |
| 日本語 | ソーシャルリスニング ツール | 複数の文字体系の混在、単語間にスペースがないこと、カタカナのブランド表記、スラングや略語 |
| スペイン語 | herramientas de social listening | スペインとラテンアメリカにまたがる地域ごとの語彙、皮肉、ハッシュタグ |
| フランス語 | outils d'écoute sociale | くだけた入力でのアクセント記号の省略、英語からの借用語、地域ごとの使い方 |
言語ごとに、次のプロセスを実行します。
- 自社のカテゴリに関する実際の投稿を100〜200件集めます。ベンダーのデモ用データではなく、自社の実例を使います。
- ネイティブスピーカーに、各投稿の言語、感情、トピックのラベル付けを依頼します。
- 同じ投稿でツールを実行し、比較します。タスクごとに別々に採点します。
- 小さいもの、回転しているもの、一部が隠れているものを含め、ロゴが入った画像付きの投稿を50件追加します。
- 当たりだけでなく、外れも記録します。誤りにパターンがあれば、その問題を改善できるかどうかがわかります。
上記のサンプル数は実用上の目安であり、統計的な基準ではありません。サンプルが多いほど、結果は安定します。
ベンダーには何を聞くべき?
見出しの件数ではなく、言語ごとの根拠を求めます。短い質問リストで、リスクの大半をカバーできます。
- どの言語でネイティブスピーカーによる評価が行われ、どの言語が翻訳経由でのみ対応されていますか?
- 分析は元の言語で行われますか、それともすべての投稿をまず英語に翻訳しますか?
- 方言、音写表記、複数言語が混在した投稿はどう処理されますか?
- すべてのインサイトの元になった投稿を見られますか?
- ビジュアル機能のうち、どれが稼働していますか?ロゴ、シーン、画像内のテキスト、動画など。
- 自分で確認できるよう、結果をエクスポートできますか?
翻訳を先に行うことが常に誤りというわけではありませんが、トーンやスラングが平板になることがあります。分析の前に翻訳するツールでは、感情分析の結果を特に慎重にテストしてください。
多言語データを意思決定にどうつなげますか?
各言語の品質を確認してから、市場を比較します。そうしないと、品質の低い言語が静かな市場に見えてしまいます。
データが信頼できるようになったら、市場ごとに読み解きます。市場別のシェア・オブ・ボイスの読み方では、同じカテゴリでも国ごとに見え方が異なることを示しており、アジアのコンテンツローカライズは翻訳ではないでは、言葉だけでなくメッセージ自体を変えなければならない理由を解説しています。ツール全体の動向については、ソーシャルリスニングツールガイドとマーケティングインテリジェンス用語集をご覧ください。
FAQ
多言語ソーシャルリスニングとは?
複数の言語の投稿を収集して分析するソーシャルリスニングで、投稿ごとに言語を判定し、その言語で読み取ります。現地の意味を失わずに、市場をまたいでカテゴリを1つの視点で見ることが目的です。
ビジュアルソーシャルリスニングとは?
SNS投稿内の画像や動画を分析するソーシャルリスニングです。よくある使い方はロゴ検出で、投稿にブランド名が書かれていなくても、ブランドのロゴを見つけられます。
SNS投稿に対するAIの言語判定は、どれくらい正確ですか?
言語、投稿の長さ、言語の混在度合いによります。プロバイダーのドキュメントには結果ごとの信頼度スコアは示されていますが、自社データでの精度は示されていないため、自社のサンプルで測定してください。
ツールのテストにネイティブスピーカーは必要ですか?
はい、感情とトピックのラベルには必要です。ネイティブスピーカーなら、ネイティブでない人が見逃すスラング、皮肉、方言に気づけます。最初のテストなら、言語ごとに数時間のレビューで通常は足ります。
ツールがすべてを英語に翻訳してくれれば十分ですか?
十分な場合もありますが、トーンに敏感な業務には向きません。翻訳によってスラングやユーモアが平板になることがあるため、頼る前に、翻訳後の結果をネイティブスピーカーのラベルと比較してください。